ReactQuery의 staleTime: 0은 정말 0일까?
아래의 코드에서 queryFn은 몇 번 요청될까?
// ScenarioPage.tsx
'use client'

function UserCard() {
  const { data: user } = useSuspenseQuery({
    queryKey: ['user'],
    queryFn: () => getUser(),
    staleTime: 0,
  })

  return (
    <article>
      <strong>{user.name}</strong>
      <small>{user.id}</small>
    </article>
  )
}

export function ScenarioPage() {
  return (
    <main>
      <p>시나리오 페이지</p>
      <Suspense fallback={<p>로딩중</p>}>
        <UserCard />
      </Suspense>
    </main>
  )
}

// page.tsx
export default async function Page() {
  const queryClient = getQueryClient();

  await queryClient.prefetchQuery({
    queryKey: ['user'],
    queryFn: () => getUser(),
  })

  return (
    <HydrationBoundary state={dehydrate(queryClient)}>
      <ScenarioPage />
    </HydrationBoundary>
  )
}
SSR에서 prefetch를 하고 이를 hydrate했으니 한 번일 것 같다. 그런데 이전 포스팅의 hydrated-stale 실험에서, 이 코드를 dev 모드에서 30회 돌렸을 때, 요청이 60회 찍히는 것을 확인할 수 있었다. 매 실행마다 queryFn이 두 번 호출된 것이다.
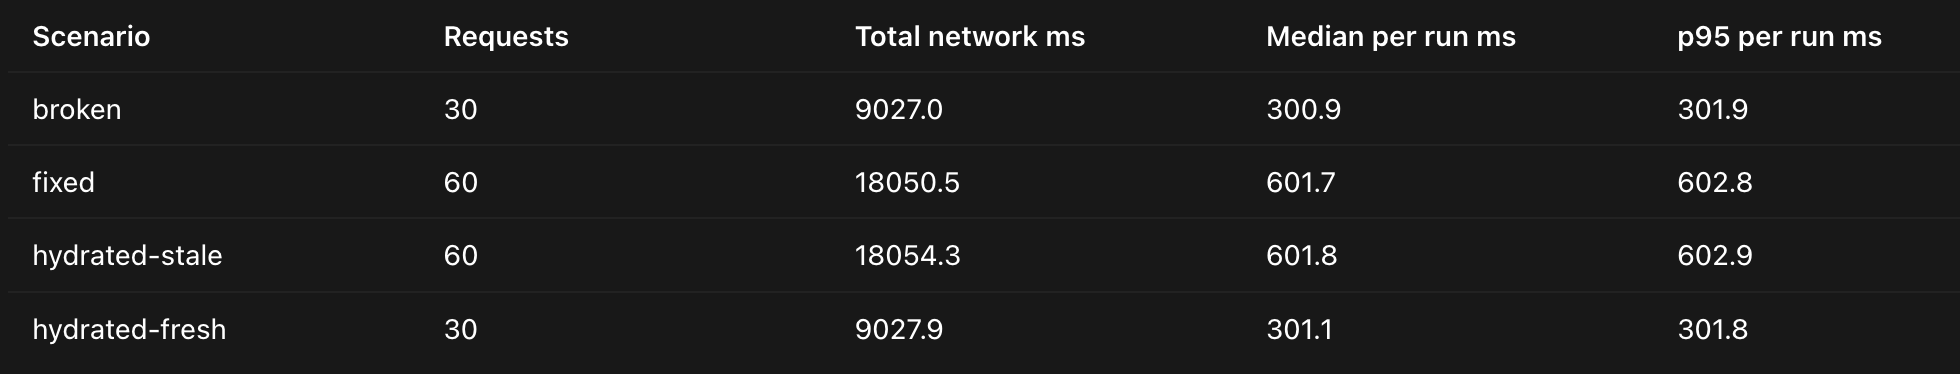
왜 두 번 찍혔을까? 이전 포스팅에서는 두 배의 이유를 staleTime이 0이기 때문이라 설명했는데, 이 설명은 옳지못했다. 그 이유를 ReactQuery의 staleTime 내부 코드를 통해 살펴보자.
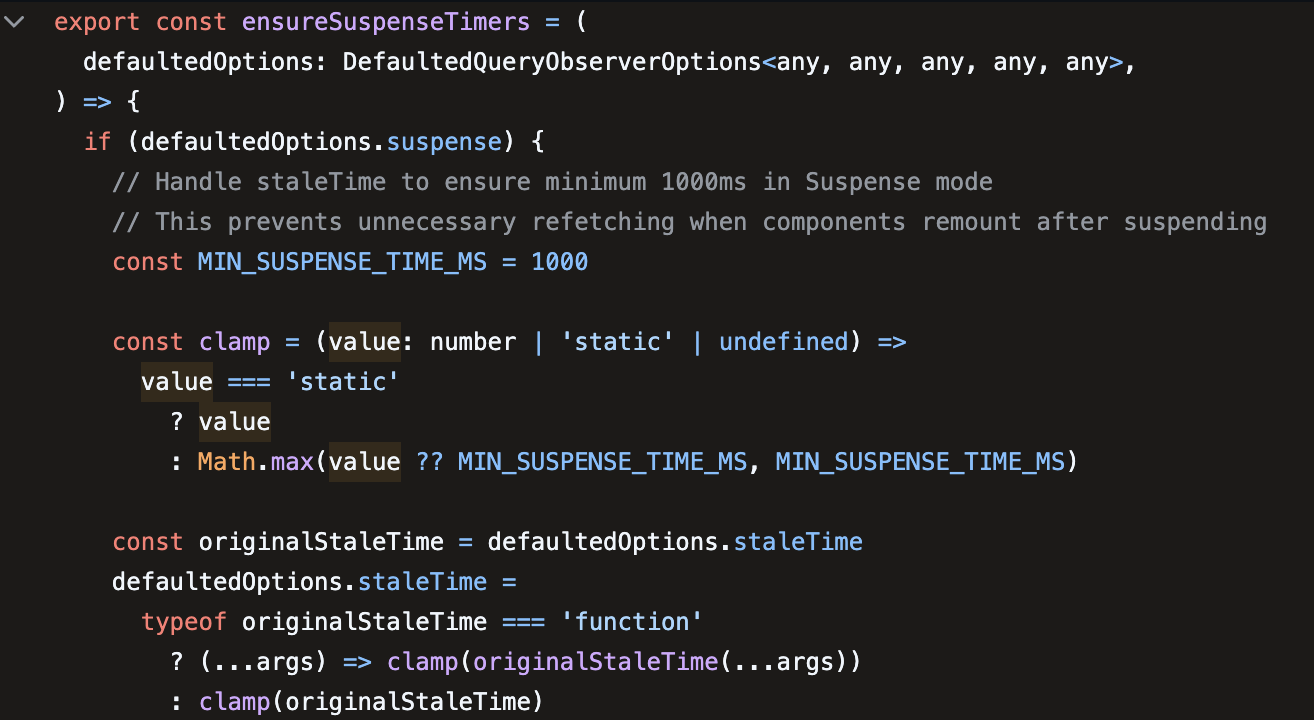
ReactQuery의 suspense.ts 코드를 보면 Suspense에서는 staleTime은 사실 0이 아님을 알 수 있다. staleTime이 0이어도 최소 1000ms로 처리되도록 하고 있다. 결국, 테스트에서 네트워크 요청이 2배 발생한 이유는 데이터가 도착한 뒤 1초가 넘었기 때문이다. 확실하게 확인하기 위해 ssr에서 prefetch되었을 때의 dataUpdatedAt과 브라우저에서 마운트된 후 Date.now()의 차이를 찍어보는 스텝을 추가해 다시 돌려보았다.
 useEffect(() => {
    const state = queryClient.getQueryState(options.queryKey)
    logMountDataAge(scenario, state?.dataUpdatedAt)
  }, [])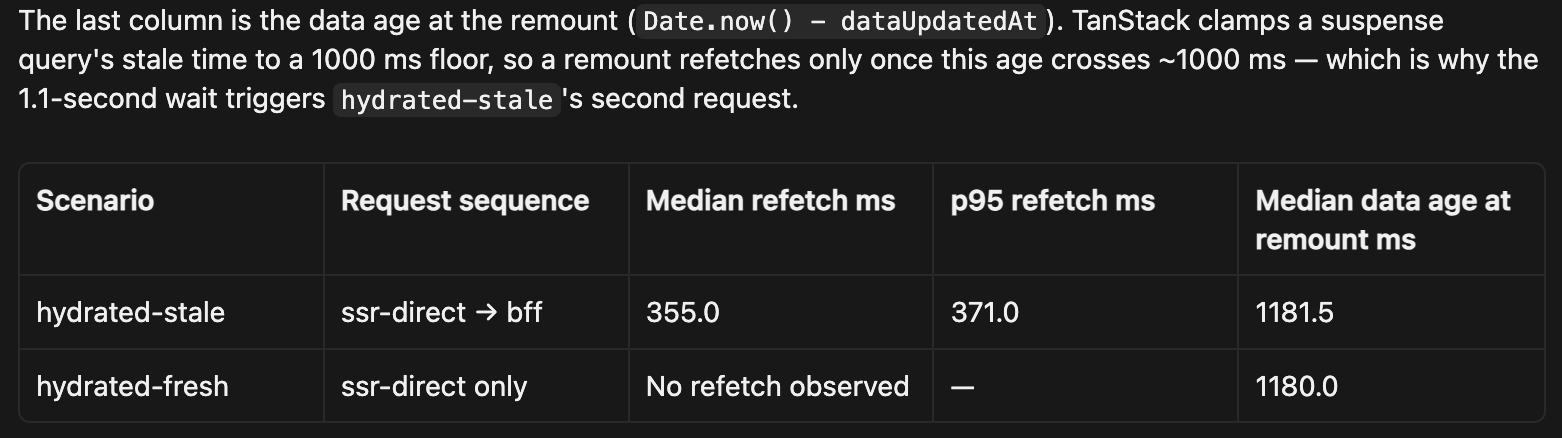
역시 결과는 1000ms를 초과했다. 그래서 stale판정이 났고, 요청이 두 번 갔던 것이다. 근데 이 1초라는 간격을 만든 건 코드가 아니라 환경이 만든 것이다. 이번 실험은 dev 모드였기 때문에 1초가 넘게 걸렸는데, 이걸 prod 모드로 돌려보면 번들링 작업이 최적화된 상태이기에, 로드와 hydration이 빠르게 끝나 1000ms안에 들어오기에 두 번 요청이 발생하지 않았다. 물론 prod 모드라도 저사양 기기나 네트워크에서는 로드되고 hydrate되는 시간이 1초보다 훨씬 길어질 수 있기 때문에 refetch가 발생할 수 있다. 그래서 첫 번째 코드 문제의 답은 '한 번 일수도, 두 번 일수도 있다'이다.
그런데 여기서 궁금한 점이 생긴다. ReactQuery는 왜 Suspense에서 1초나 stale 판정을 지연 시킨걸까? 위 suspense.ts 주석을 살펴보면 suspense 이후 컴포넌트가 remount 되었을 때, 불필요한 refetch를 줄이기 위해서라고 한다. 그럼에도 의문이 가시지 않는다. 왜 1000ms가 불필요한 refetch를 줄여주는걸까? 실제로 데이터 도착 시간을 300ms로 가정했을 때, 이게 바로 반영이 된다면 700ms는 꽤나 큰 차이이다. 데이터는 보통 1초보다 훨씬 빨리 도착하는데 왜 지연을 저만큼이나 둔걸까? 만약 그냥 넉넉하게 둔 것이라면 useQuery는 왜 minTime을 1000ms로 두지 않은걸까? 그 이유는 아래의 React PR에서 확인할 수 있었다.
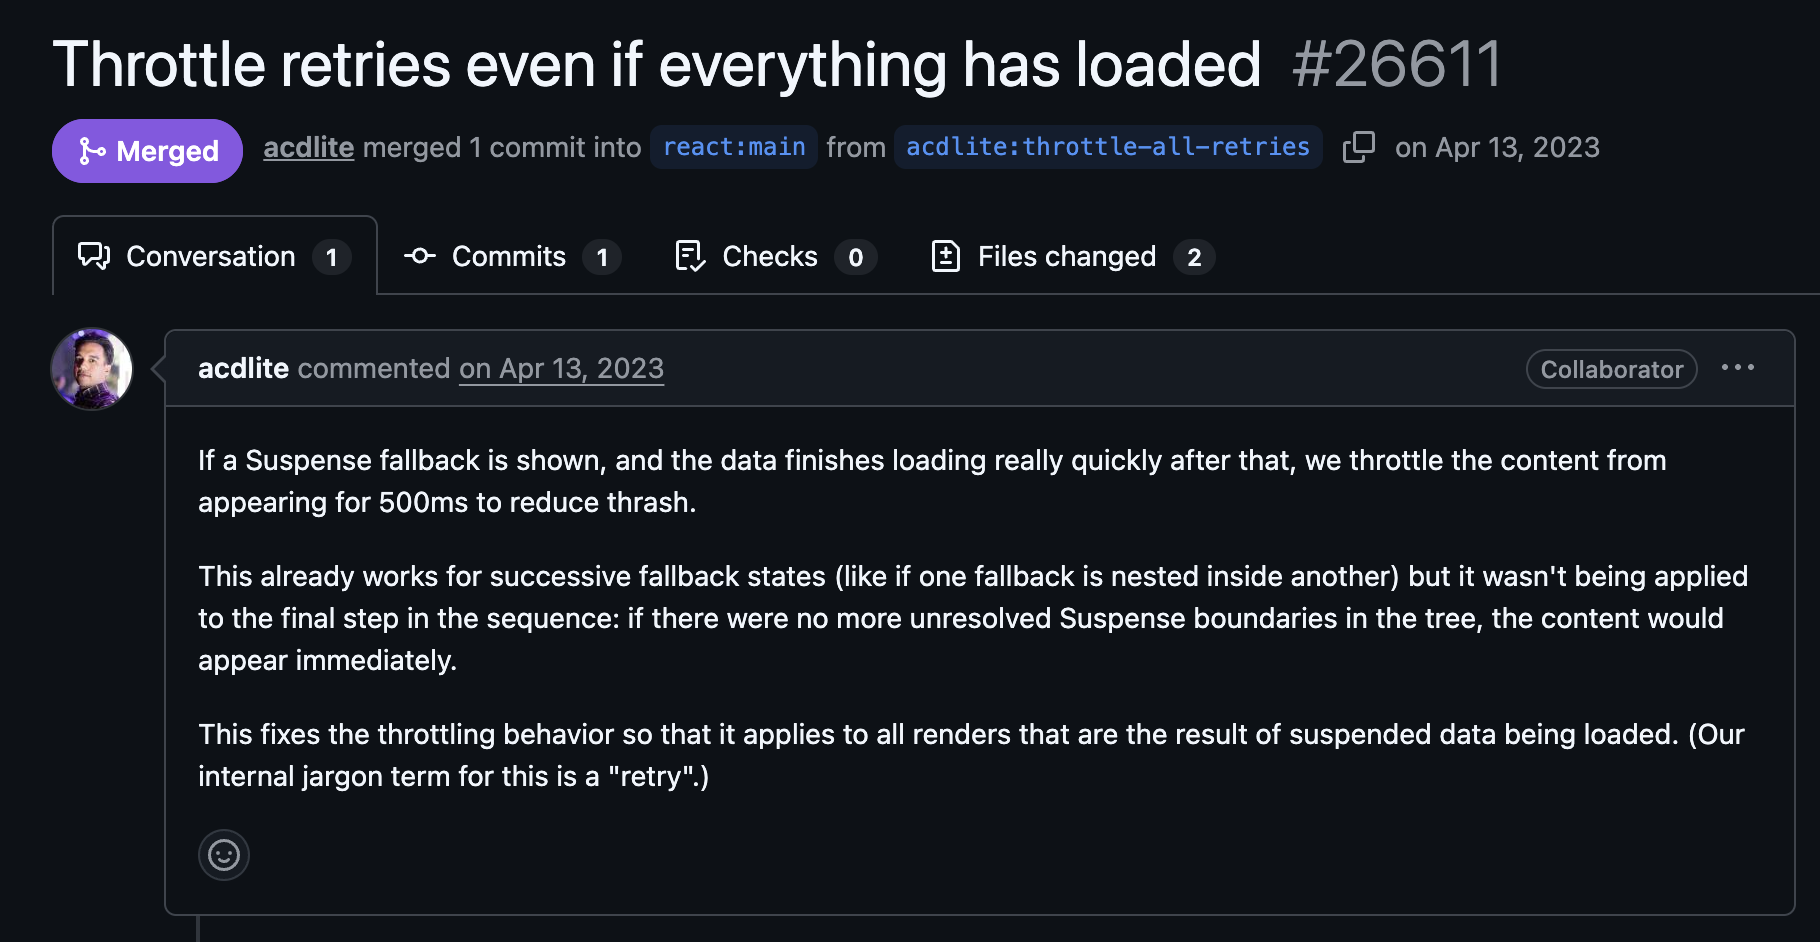
이 PR 내용을 요약하자면, Suspense에서 fallback이 화면에 보여지고 요청한 데이터를 화면에 반영하기까지 500ms throttle을 발생시킨다는 것이다. 그런데 마지막 시퀀스에서는 throttle이 발생하지 않았고, 이번 작업으로 모든 커밋에 마지막까지 throttle을 발생시킨다는게 주된 내용이다.
즉, React에서 애초에 suspense 안에서 직전 커밋부터 throttle을 500ms를 줘버리니까, 이게 mount될 때쯤이면 데이터가 도착한 시간보다 더 오래걸리게 된다. 최악의 상황에서 400ms, 523ms에 데이터들이 도착하면 반영되기까지 밀려서 throttle 500ms가 추가되어 버릴 수 있으니 ReactQuery에서는 이를 고려해 1초 정도를 stale하게 판정한 것으로 보인다. 안그럼 UI에 반영되기도 전에 두 번이나 fetch될 수 있으니말이다. 이에 대한 자세한 실험은 아래에 있다.
그런데 React에서는 왜 데이터를 바로 UI에 반영하지 않고 이런 작업을 하는걸까? 데이터는 빨리 보여줄 수록 좋지않나? 본문에서는 이를 thrashing을 줄이기 위해서라고 말한다. 처음에 이 PR을 읽었을 때, 어떤 thrashing이 발생하는 것일지 와닿지 않았다. 결국 data를 UI에 반영하기까지의 문제인데, 어떤 thrash를 줄이려고 한걸까? 너무 요청이 많아서? 혹은 fallback을 보여주고 있으니 양보하고 더 급한 작업들을 처리하기 위해서? PR 코드를 보고 힌트를 얻었다.
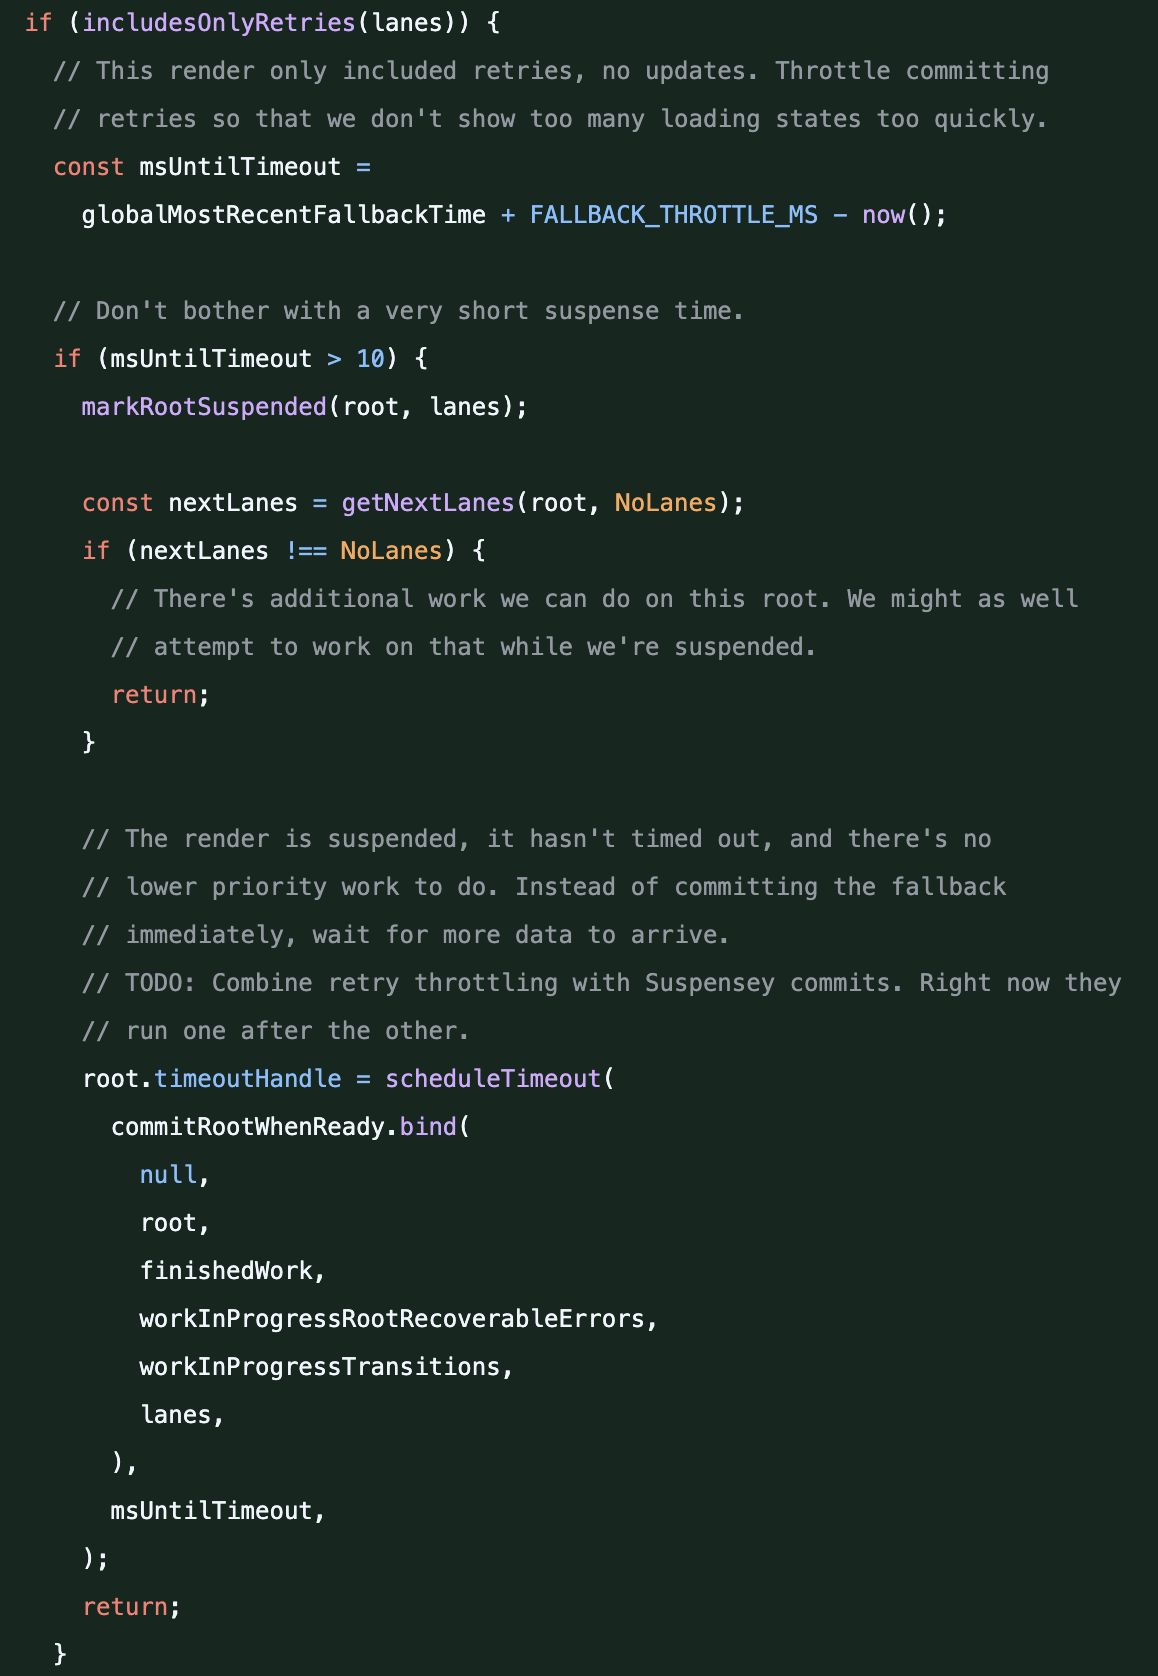
주석을 보면, 너무 많은 로딩들이 빠르게 보였다 사라졌다 하는 것을 방지하기 위해서라고 한다. 예를 들어, 여러 개의 Suspense가 존재할 때, 만약 throttle이 없다면 데이터가 오는 대로 화면에 반영할 것이다. 그러다보면 loading fallback이 각각 보였다 사라졌다 버벅거리는 느낌이 나게 된다. 실제로 확인해보기 위해 sandox 실험을 또 돌려봤다.
export function ThrottleExperiment({
  runId,
  delays,
}: {
  readonly runId: string
  readonly delays: readonly number[]
}) {
  const [started, setStarted] = useState(false)
  const startEpoch = useRef(0)

  useLayoutEffect(() => {
    startEpoch.current = Date.now()
    setStarted(true)
  }, [])

  if (!started) {
    return <p data-experiment-status="pending">Starting experiment…</p>
  }

  return (
    <MeasurementProvider
      startEpoch={startEpoch.current}
      expectedReveals={delays.length * 3}
    >
      <p data-experiment-status="running">
        Open the Console and Performance tabs to watch reveals land.
      </p>
      <div style={{ display: 'flex', flexWrap: 'wrap', gap: 12 }}>
        <section style={columnStyle} aria-label="Sibling Suspense column">
          <h2>Sibling</h2>
          <SuspenseColumn runId={runId} delays={delays} />
        </section>
        <section style={columnStyle} aria-label="Nested Suspense column">
          <h2>Nested</h2>
          <NestedSuspenseColumn runId={runId} delays={delays} />
        </section>
        <section style={columnStyle} aria-label="Baseline column">
          <h2>Baseline</h2>
          <BaselineColumn runId={runId} delays={delays} />
        </section>
      </div>
      <ResultsPanel delays={delays} />
    </MeasurementProvider>
  )
}

Suspense를 차례대로 형제, 중첩, 적용하지 않았을 때를 테스트한 결과다. Sibling과 Nested에서 매 커밋마다 throttle이 적용되어 revealed되고 있음을 알 수 있다. 그런데 수치 값에서 revealed의 간격이 위 PR과 다른 결과를 확인할 수 있었다. PR에서는 throttle이 500ms였으나, 실제 실험에서는 노출이 308ms, 608ms, 908ms로 300ms 단위로 되고 있었다. 값이 변경된 것일까? 그럼 또 500ms에서 300ms로 throttle 시간을 변경시킨 이유는 무엇일까? PR을 뒤져봤다.
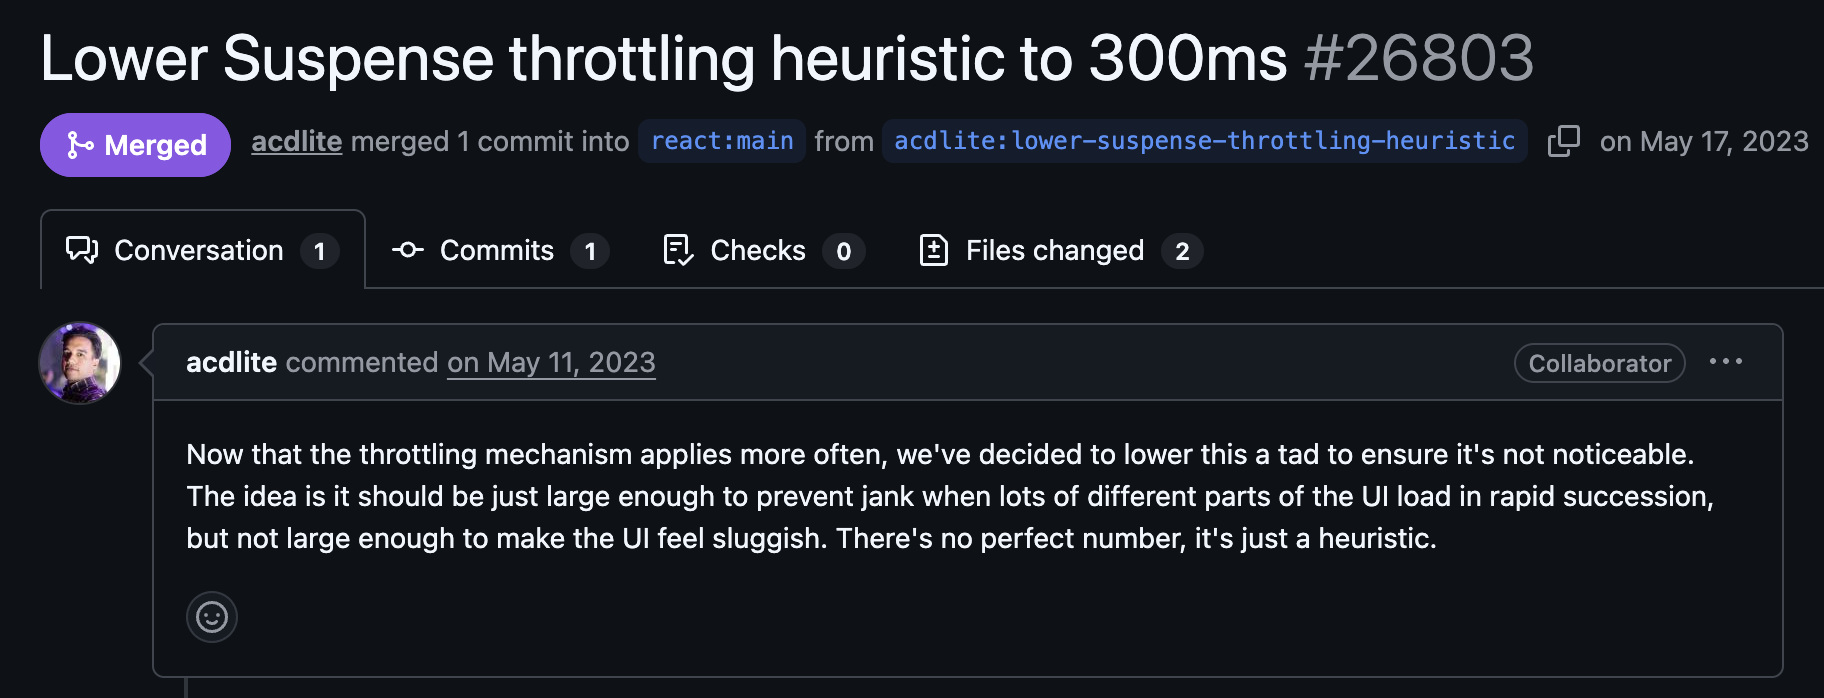
찾은 PR 설명을 보니 왜 throttling을 적용한 것인지 이유가 명확해졌다. 이전 PR(#26611)에서 throttle 범위를 넓혔으니 빠른 연속된 UI 로드가 될 때, 아까 예상했던 버벅임(jank)를 방지하기 위한 최적의 시간을 500ms에서 300ms로 낮췄다는 내용이다. 300이란 숫자는, 완벽한 magic number는 존재하지 않기에, UI가 느릿한(sluggish) 느낌이 들지 않는 수준에서 휴리스틱하게 300으로 정했다고 했다. 한 페이지에 많은 데이터들을 불러오는데 이 턴이 500ms이면 Suspense 중첩이 많은 페이지에서는 확실히 500은 조금 길게 느껴질 것이다. 실험을 통해서 300ms로 3번 중첩만 돼도 느리게 나타나는 느낌이 들었으니 말이다.
그런데 이 메커니즘을 이해하면서 헷갈리는 부분이 있었는데, 문제로 확인해보자. 만약 데이터 도착이 100ms이면 언제 reveal 될까? 정답은 300ms이다. fallback 커밋 이후 throttle이 발생했기 때문이다. 그럼 데이터가 324ms에 도착한다면 언제 reveal될까? 324ms에 reveal된다. 이 부분이 조금 헷갈렸던 부분인데, 이유는 fallback 커밋 이후의 throttle은 끝이 났고, 새로운 커밋이 없었기 때문이다. 마지막으로 데이터가 100ms, 324ms에 도착한다. 각각 언제 reveal될까? 300ms, 600ms가 될 것이다. 이유는 300ms에 커밋이 되었고, throttle이 발생했기 때문이다. 관련 PR 코드는 아래에서 확인해볼 수 있다. 지금의 main과는 함수의 파라미터들이 더 추가된 부분들이 좀 다르긴하지만 핵심 플로우는 동일하다.
   if (includesOnlyRetries(lanes)) {
      // This render only included retries, no updates. Throttle committing
      // retries so that we don't show too many loading states too quickly.
      const msUntilTimeout =
        globalMostRecentFallbackTime + FALLBACK_THROTTLE_MS - now();

      // Don't bother with a very short suspense time.
      if (msUntilTimeout > 10) {
        markRootSuspended(root, lanes);

        const nextLanes = getNextLanes(root, NoLanes);
        if (nextLanes !== NoLanes) {
          // There's additional work we can do on this root. We might as well
          // attempt to work on that while we're suspended.
          return;
        }

        // The render is suspended, it hasn't timed out, and there's no
        // lower priority work to do. Instead of committing the fallback
        // immediately, wait for more data to arrive.
        // TODO: Combine retry throttling with Suspensey commits. Right now they
        // run one after the other.
        root.timeoutHandle = scheduleTimeout(
          commitRootWhenReady.bind(
            null,
            root,
            finishedWork,
            workInProgressRootRecoverableErrors,
            workInProgressTransitions,
            lanes,
          ),
          msUntilTimeout,
        );
        return;
      }
    }
    commitRootWhenReady(
      root,
      finishedWork,
      workInProgressRootRecoverableErrors,
      workInProgressTransitions,
      lanes,
    );
  }
scheduleTimeout()에서 커밋 함수를 throttle 시간만큼 뒤로 미루는 것이다. 그리고 신기한 점은 nextLanes에서 아까 추측했던 우선순위 작업도 처리해주고 있었다. 주석이나 PR로 보면 이게 주 목적은 아니지만, 기다리는 김에 처리를 해주고 있는 듯 했다.
이렇게 staleTime에서 시작해 React의 Suspense 렌더링 동작까지 알아보았다. 이 모든 것들을 제대로 알고있어야, 지난 글에서 고민했었던 staleTime에 대해 제대로 정할 수 있겠구나 싶었다. staleTime은 그냥 예측으로 정하는 캐싱 시간 정도라 생각했는데, 사실 이건 서버에서 데이터가 오고나서 화면에 마운트 되기까지의 간격을 파악하는 일이었다. 물론, 앞선 throttling Time PR이나 ReactQuery 최소 staleTime에서처럼 완벽한 숫자는 없고 휴리스틱한 숫자겠지만, 지금 내 프로젝트의 번들 크기, 주로 사용되는 기기, 국가 환경에 따라 알맞게 설정한다면 네트워크 요청을 최적화할 수 있는 방법이 되기 때문이다.